Retour aux projets
Epitech Hub · Solo
WorldVideo
Un ConvLSTM qui regarde 10 images d’une vidéo et prédit les 10 suivantes.
- Python
- PyTorch
- ConvLSTM
- Période
- Juin – juil. 2026
- Équipe
- Projet solo
- Code
- Voir le code
Le projet
WorldVideo prédit la suite d’une vidéo. À partir des 10 premières images d’une séquence, le modèle génère les 10 suivantes.
Le modèle est un ConvLSTM à 4 couches de 128 canaux, entraîné sur Moving MNIST : 10 000 séquences de 20 images en 64 × 64. Je l’évalue en MSE et en SSIM.
Ce qui a été difficile
- Entraîner un ConvLSTM de 4 couches de 128 canaux demande un GPU : l’entraînement s’est fait sur une autre machine, sans réseau entre les deux.
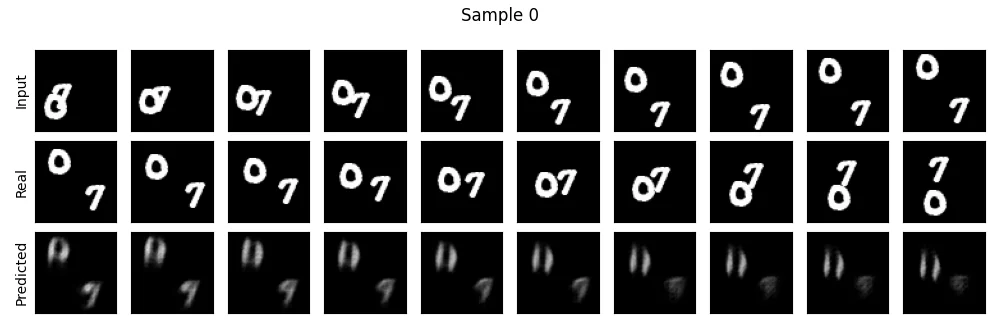
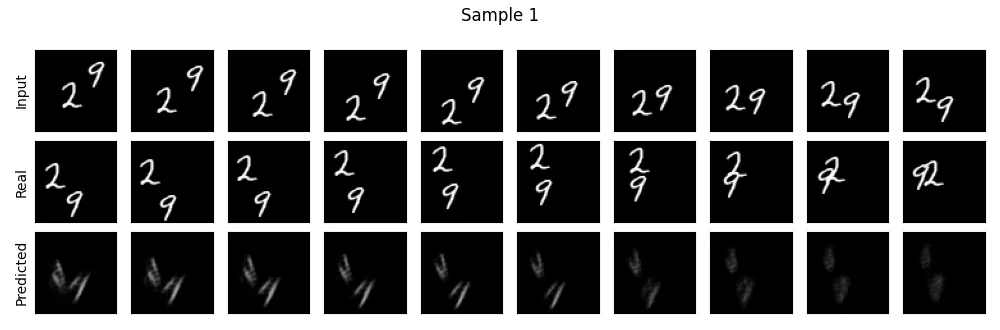
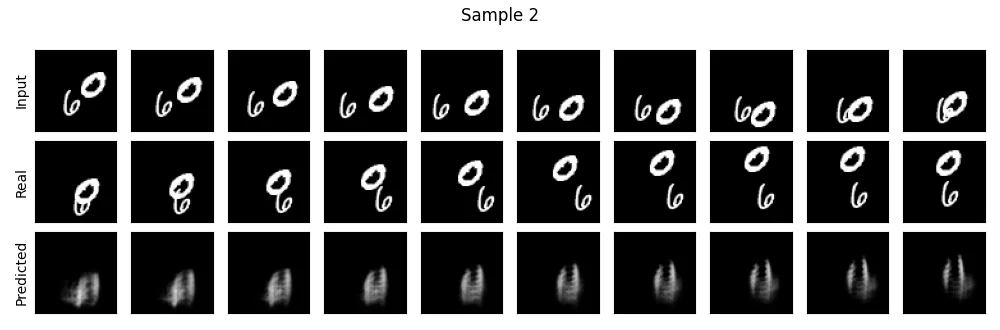
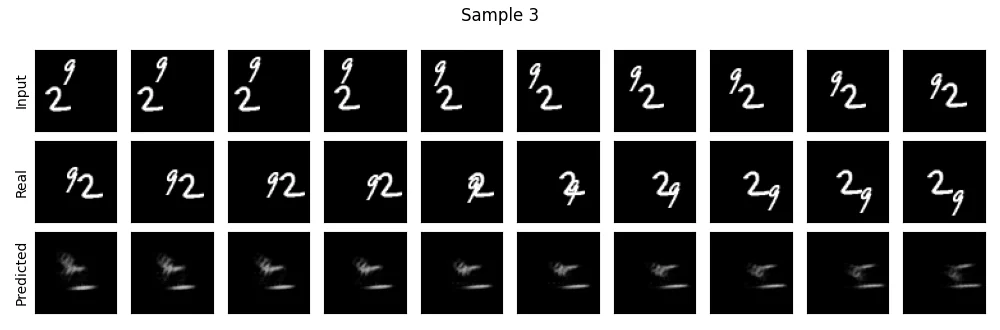
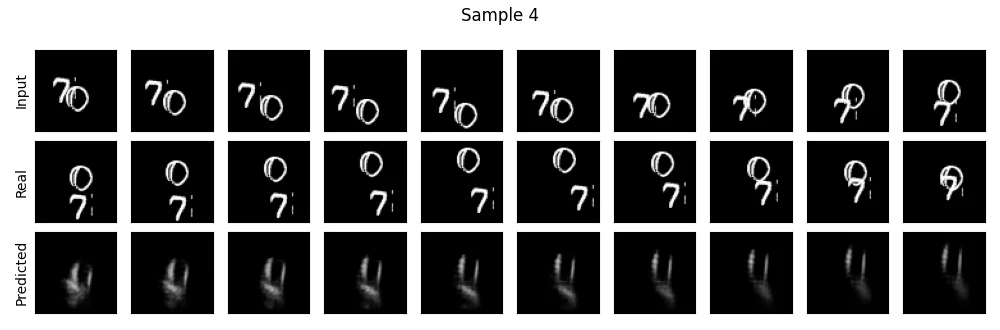
- Plus la prédiction s’éloigne des 10 images d’entrée, plus elle se brouille, surtout quand deux chiffres se croisent.
Ce que j’ai appris
- Partir d’une architecture de référence, celle d’OpenSTL, l’adapter et la créditer, plutôt que de tout réécrire.
- Évaluer une prédiction d’images avec deux métriques qui se complètent : la MSE, pixel par pixel, et la SSIM, qui regarde la structure.
- Suivre un entraînement de bout en bout avec Weights & Biases.
Essayer.
Réel contre prédit
À gauche la séquence réelle, à droite ce que le modèle génère. Mettez en pause et avancez image par image : la prédiction se brouille à mesure qu’elle s’éloigne des images de départ.
Entrée, réel, prédit
Pour une séquence : les 10 images d’entrée, les 10 images réelles qui suivent, puis les 10 images prédites.
Crédits
- Architecture ConvLSTM adaptée d’OpenSTL (licence Apache 2.0).
- Données : Moving MNIST, Srivastava et al., 2015.