Epitech · 3e année · Solo
my_torch
Un réseau de neurones écrit de zéro en NumPy, qui lit une position d’échecs et dit s’il y a échec ou mat.
- Python
- NumPy
- Deep learning
- Période
- Oct. – nov. 2026
- Équipe
- Projet solo
- Code
- Voir le code
Le projet
my_torch est un module de réseaux de neurones que j’ai écrit en Python avec NumPy, sans aucune bibliothèque de deep learning. Couches denses, activations, initialisations, coûts, optimiseurs, mini-batch, régularisation L2, early stopping, dropout et MC dropout, planification du learning rate : tout est codé à la main, backpropagation comprise.
Je l’ai appliqué aux échecs. À partir d’une position en notation FEN, encodée en 769 entrées, le réseau prédit Nothing, Check ou Checkmate, avec la couleur concernée.
Je joue aux échecs (1 400 Elo). Apprendre à un réseau ce que je vois sur l’échiquier, sans framework pour cacher les maths, était le meilleur moyen de comprendre ce qui se passe vraiment pendant un entraînement.
En chiffres
- Check / Nothing, sur la partie de test
- 95,7 %
- Checkmate / Check / Nothing avec couleurs, sur la partie de test
- 90,0 %
- positions de vraies parties dans le dataset
- 723 019
- tests réussis au correcteur
- 10 / 10
Ce qui a été difficile
- Ma première version, entraînée sur 80 000 positions tirées de parties aléatoires, ne réussissait que 2 tests sur 10 au correcteur. Sur de vraies parties, elle tombait à 53,6 % : elle voyait des échecs partout.
- Écrire la backpropagation à la main, pour six activations, sans framework pour signaler une erreur. Certaines erreurs ne se voient pas tant qu’on n’utilise que ReLU.
- Le surapprentissage : sans régularisation, 95,8 % sur l’entraînement pour 85,3 % sur la validation.
Ce que j’ai appris
- Les données comptent plus que l’architecture : passer aux positions de vraies parties a fait gagner plus de 30 points, quand les architectures comparées ne différaient que d’un point.
- Vérifier des gradients par différences finies, sur des réseaux assez variés pour faire apparaître les erreurs.
- Choisir sur la validation, mesurer une seule fois sur le test, et fixer toutes les graines pour que chaque résultat se refasse à l’identique.
Essayer.
Le réseau, en direct
Placez les pièces, ou chargez une position. Le vrai réseau entraîné tourne dans votre navigateur avec le code Python du dépôt, et sa réponse est comparée aux règles du jeu.
Les benchmarks
Chaque choix du réseau final a été comparé à ses alternatives, sur les mêmes données.
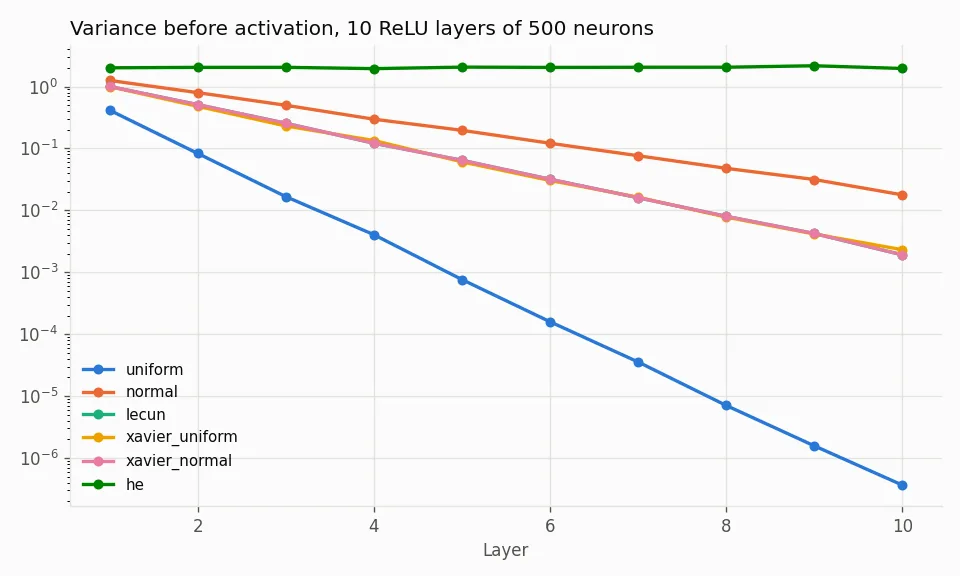
Stabilité du signal selon l’initialisation 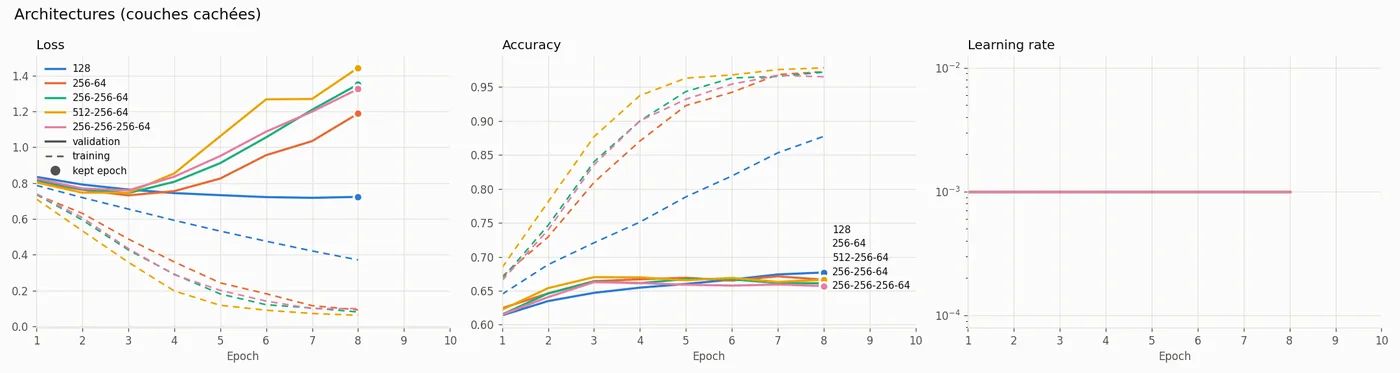
Architectures · courbes d’apprentissage 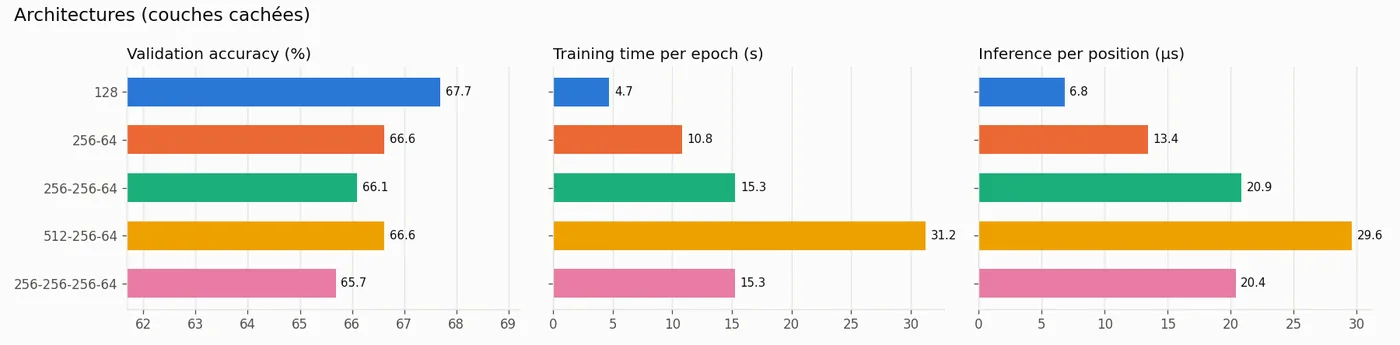
Architectures · résumé 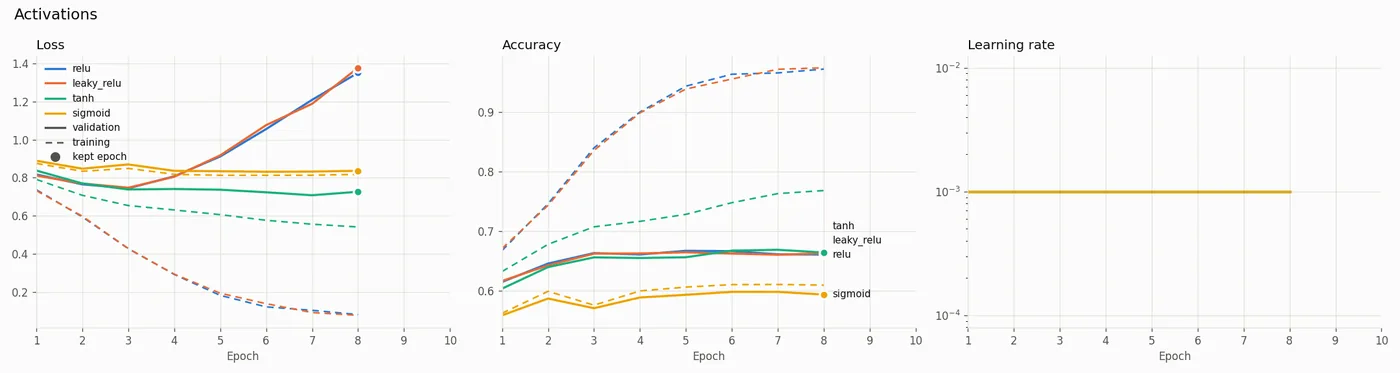
Activations · courbes d’apprentissage 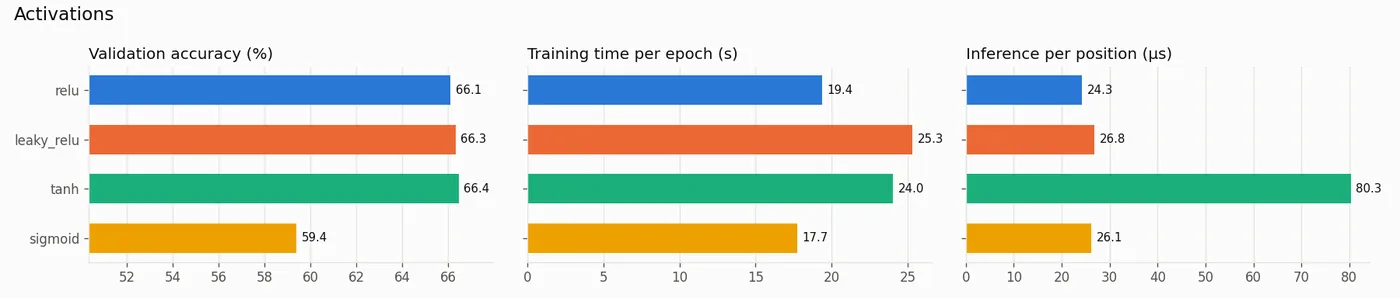
Activations · résumé 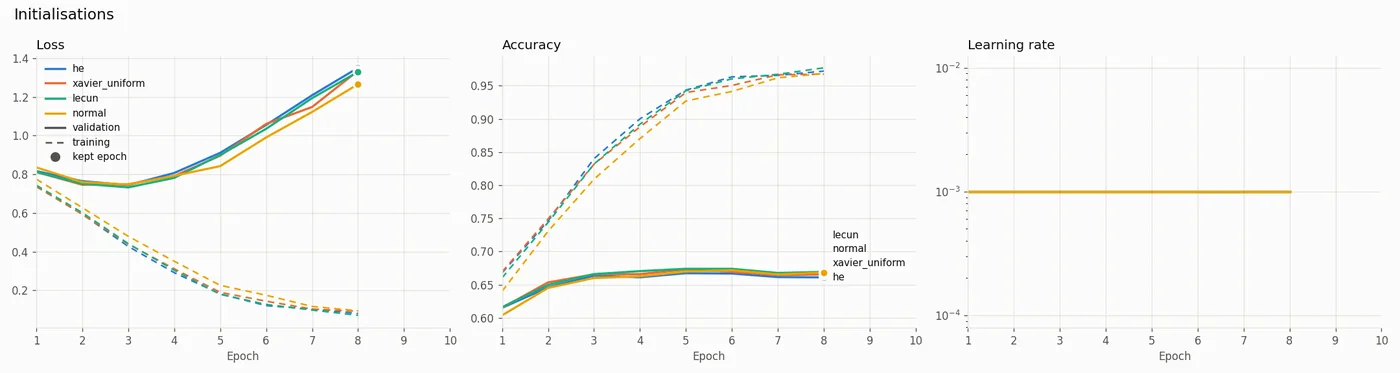
Initialisations · courbes d’apprentissage 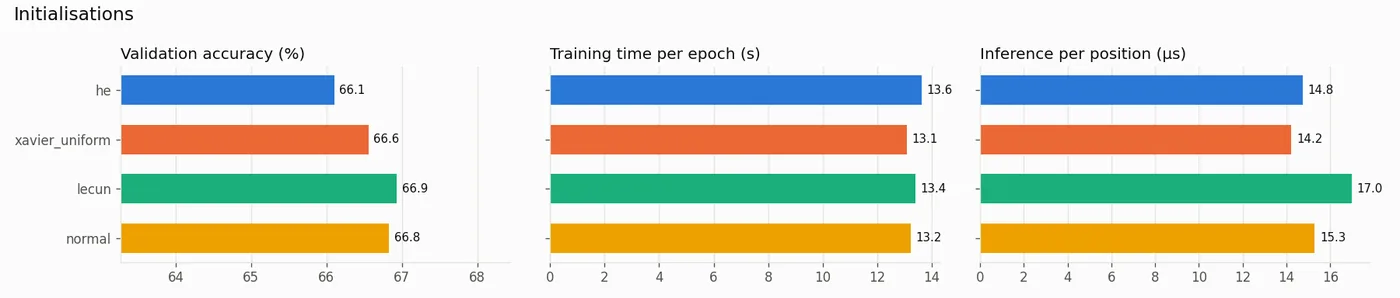
Initialisations · résumé 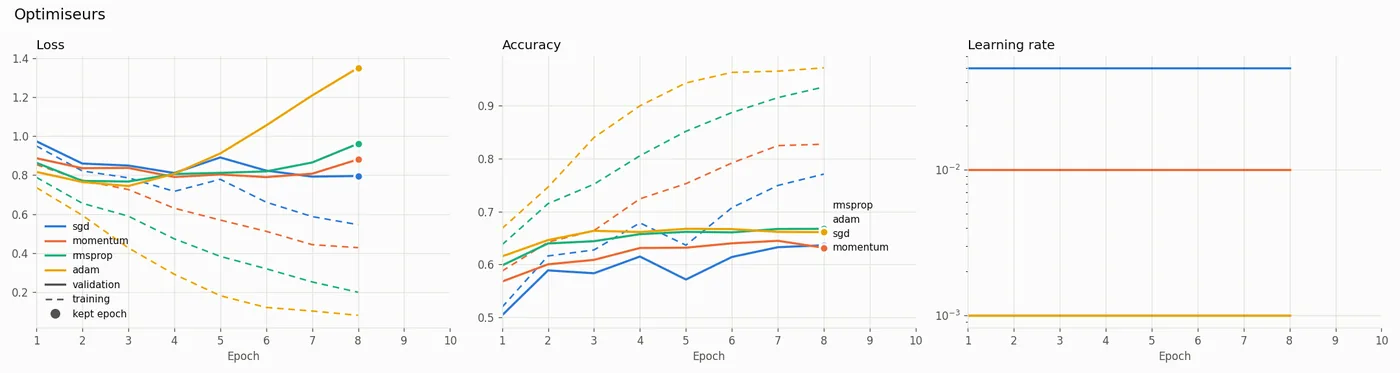
Optimiseurs · courbes d’apprentissage 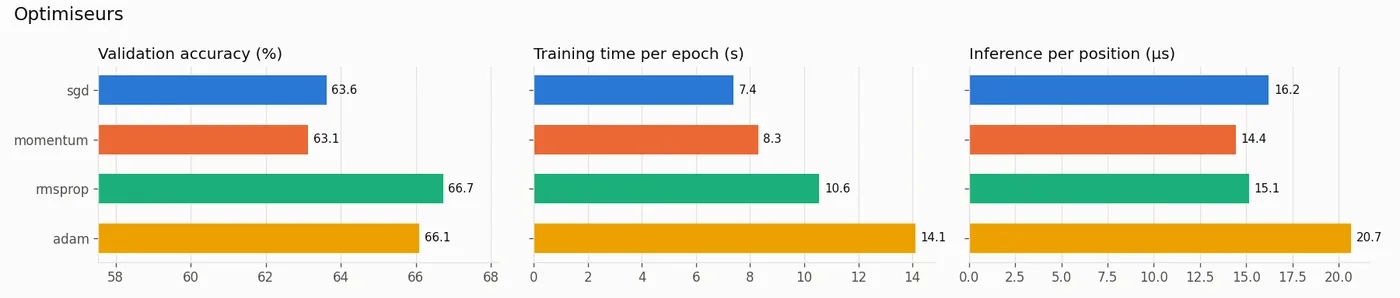
Optimiseurs · résumé 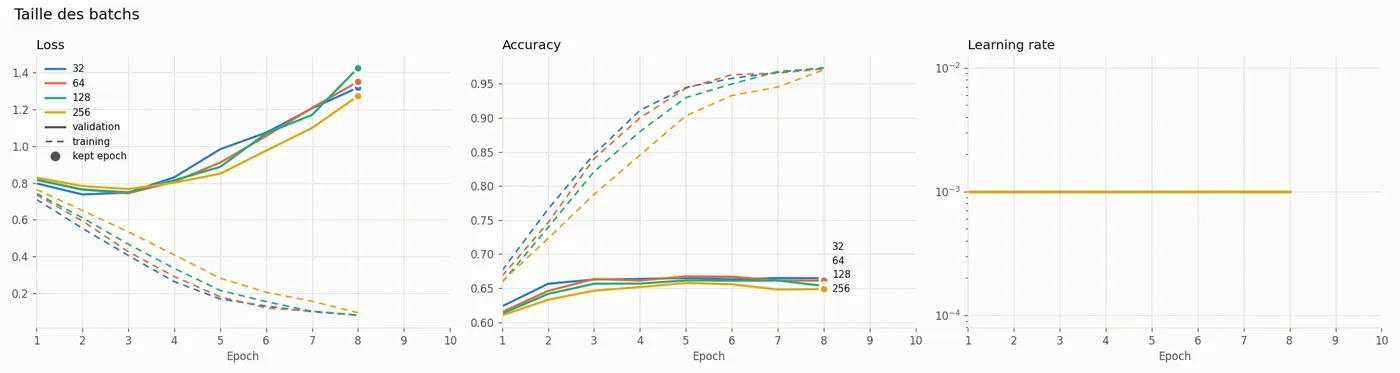
Taille des batchs · courbes d’apprentissage 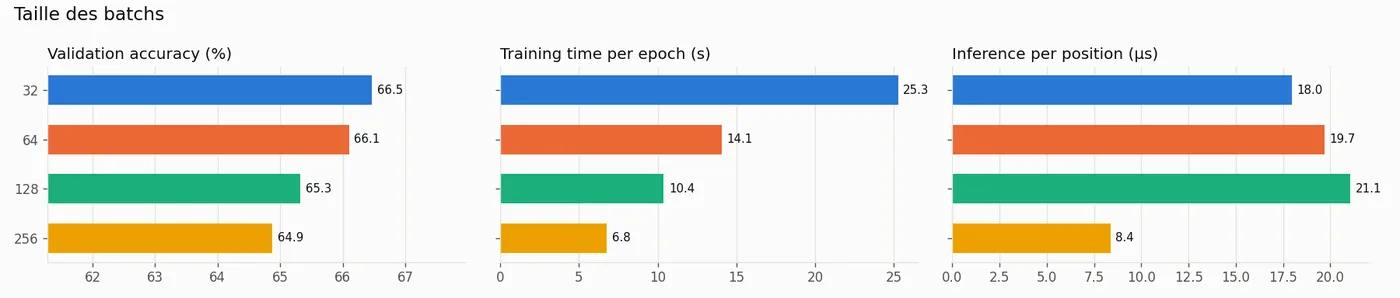
Taille des batchs · résumé 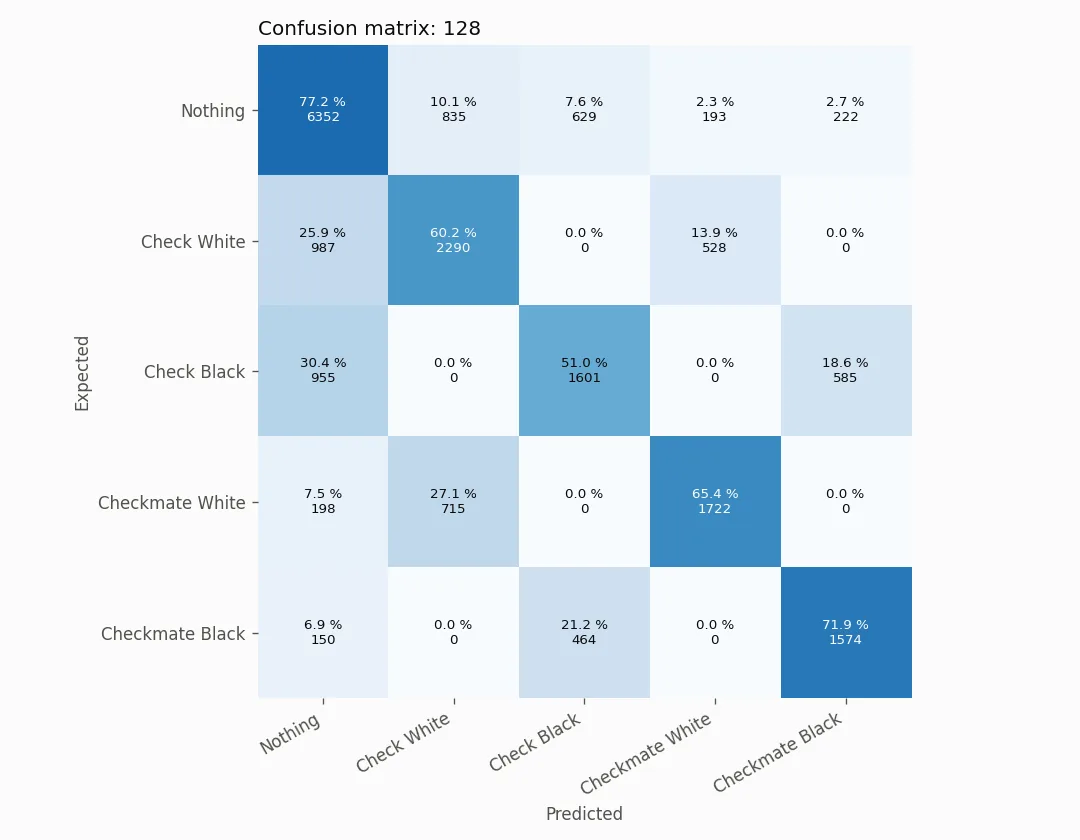
Matrice de confusion
Crédits
- Pièces d’échecs : Colin M.L. Burnett (licence BSD).
- Python dans le navigateur : Pyodide (MPL 2.0). Règles du jeu : chess.js (BSD).